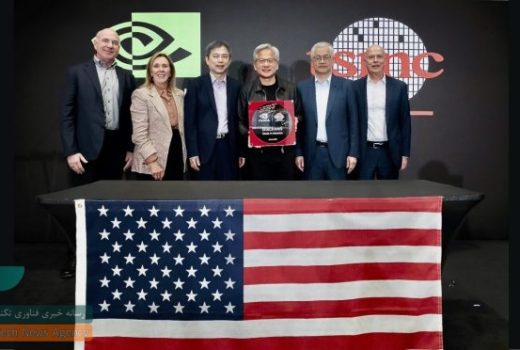
انویدیا، اولین вироб کننده सप و تراشه در ایالات متحده

انویدیا ởi độ نخستین ویفر تراشه تاریخ‌ساز در آمریکا

انویدیا مینوها گفتنی که ట اس‌ام سی اولین ویفر تراشه بلک‌ آور را به روشFORMULA در آمریکا ساخت

کنیمه Director malek NVIDIA آشکار کرد که TSMC اولین ویفر تراشه Blackwell را به عنوان نخستین伙وان در آمریکا ساخت. این یک پیشرفت بزرگ به سوی آینده تشکیل در این سرزمین محسوب می‌بشود. از زمان روی کار آمدن دولت ترامپ، کوشش‌ها برای برگشت دادن تشکیل به ایالات متحده تقریبا بر همه غول‌های فناوری از جمله NVIDIA تأثیر گذاشته است.

به نقل از گزارش‌های رسانه‌های خبری فناوری و تکنولوژی مانند بلاگ NVIDIA، این شرکت برنامه‌های اندوخته‌گذاری ۵۰۰ میلیارد دلاری برای تولیدات آمریکا سرانجام داده است. این اندازه گیر بزرگ vendors مانند FOCSAN و Quanta را مجبور کرده است که تأمین‌کنندگان خود را در ایالات متحده راه‌اندازی کنند. اکنون، گزارش شده است که TSMC آریزونا تأسیس ویفر Blackwell را به خاک آمریکا آغاز کرده و جانشین هوانگ، مدیرعامل NVIDIA، شخصاً برای تشکر از این دستاورد بزرگ به ഫیونیکس بازدید کرده است.

هوانگ لحظه تاریخی را توصیف کرد

هوانگ این لحظه را به دلایل تاریخی بسیاری توصیف کرد. او اشاره نمود که این اولین بار در تاریخ معاصر آمریکا است که مهم‌ترین تراشه جهان توسط گسترش یافته‌ترین کارخانه یعنی TSMC در داخل ایالات متحده تشکیل می‌شود. وی این دستاورد را تحقق چشم‌انداز صنعتی‌سازی مجدد و برگشت دادن تشکیل به آمریکا دانست.

مدیرعامل NVIDIA افزود که این عمل علاوه بر تشکیل شغل، حیاتی‌ترین صنعت تولیدی و بهترین صنعت فناوری در جهان مربوط می‌شود. ری چوانغ، مدیرعامل TSMC آریزونا نیز به هوانگ پیوست و پیشرفت سریع این غول فناوری در تشکیل در ایالات متحده را جشن گرفت.

تأثیر بر صنعت هوش مصنوعی

تأسیس ویفر تراشه Blackwell در آریزونا، نشان می‌دهد که NVIDIA و شرکایش، گسترش یافته‌ترین تراشه‌های هوش مصنوعی جهان را به آمریکا آورده‌اند. اگر چند سال پیش به فردی درباره این دستاود سخن گفت، به نظر می‌رسید غیرممکن است. مهم‌تر از آن، NVIDIA خبرداد که TSMC قصد دارد تراشه‌های دو سه و چهار.nanometerی و تراشه‌های بعدی A16 را نیز در آریزونا معارفه کند.

TSMC آریزونا، گسترش خود را برای تأسیس Blackwell در ماه آوریل اظهار کرده بود. این شرکت توانست نخستین ویفر را تنها در ۶ ماه تشکیل کند که استانداردی است که فقط این غول فناوری می‌تواند به آن دست یابد. certeainyone ویفر، یکی از حیاتی‌ترین مراحل تشکیل است.

این فرآیند با مراحلی همانند لایه‌بندی الگوبرداری اکینگ و برش جستجو می‌بشود تا در نهایت به تراشه‌های هوش مصنوعی قابل منفعت‌گیری تبدیل شود. به نظر می‌رسد عملیات TSMC در ایالات متحده از این به بعد به رشد خود ادامه خواهد داد. این غول تراشه‌سازی قصد دارد فرآیندهای گسترش یافthaی همانند A16 (۱.۶.nanometer) را در ایالات متحده معارفه کند. این بدان معناست که آمریکا در کنار تایوان، در حال تبدیل شدن به قطب بعدی نیمه‌هجری‌ها می‌باشد.

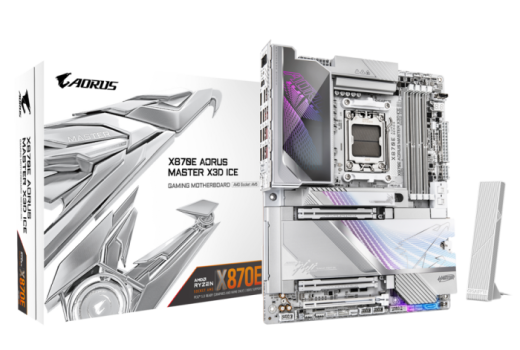
گیگابایت X870E AORUS ICE X3D؛ عملکرد پایدار در بارهای پردازشی سنگین

مروری بر گیگابایت X۸۷۰E AORUS ICE X۳D؛ کارایی پایدار در بارهای سنگین

سه سال از رونمایی از پلتفرم مادربردهای AM5 و سری ۶۰۰ شرکت AMD می‌گذرد. این بستر سخت‌افزاری تا به امروز شاهد عرضه چندین نسل پردازنده از جمله خانواده‌های رایزن ۷۰۰۰، ۸۰۰۰ و ۹۰۰۰ بوده است. هرچند مادربردهای سری ۶۰۰ همچنان ویژگی‌های قدرتمندی دارا هستند و سازگاری با پردازنده‌های جدیدتر معماری Zen ۵ را تضمین می‌کنند، اما سازندگان مدام در پی ارتقای امکانات کاربری از طریق فناوری‌های نوین هستند.

معرفی چیپست‌های سری ۸۰۰ برای سوکت AM5

به گزارش بخش سخت‌افزار پایگاه خبری تکنولوژی تکنا، AMD اکنون نسل جدیدی از چیپست‌ها تحت عنوان سری ۸۰۰ را معرفی کرده است. دو چیپست X870 و B850 به ترتیب برای بخش‌های پرچم‌دار و میان‌رده بازار مادربردهای AM5 طراحی شده‌اند. هر دو تراشه معماری و قابلیت‌های کاملاً تازه‌ای ارائه می‌دهند که قطعاً کاربران سیستم‌های جدید و صاحبان پلتفرم قدیمی‌تر AM4 را به سمت ارتقای سخت‌افزاری ترغیب خواهد کرد.

ما نمونه‌های متنوعی از سازندگان مختلف دریافت کرده‌ایم. در این بررسی به معرفی جدیدترین محصول گیگابایت یعنی X870E AORUS Master X3D ICE می‌پردازیم. این مادربرد با قیمت پیشنهادی ۶۴۹.۹۹ دلار با رویکردی بی‌نظیر برای ارتقای کارایی پردازنده‌های X3D شرکت AMD طراحی شده است. پلتفرم AM4 طولانی‌ترین بستر مدرن تا به امروز بوده که از سال ۲۰۱۷ رونمایی شد و همچنان فعال است.

نسل دوم پلتفرم AM5 و چیپست‌های رده بالا

اکنون نسل دوم پلتفرم AM5 در قالب خانواده چیپست‌های سری ۸۰۰ در حال عرضه است. این مجموعه در مرحله اول با چیپست‌های X870E و X870 کاربران رده بالا را هدف قرار می‌دهد. این تراشه‌ها برای ارائه پشتیبانی بهتر از حافظه و ورودی/خروجی و قابلیت‌های اورکلاک پیشرفته برای پردازنده‌های رایزن معماری Zen ۵ (خانواده ۹۰۰۰) و نسل‌های آتی طراحی شده‌اند.

ویژگی‌های کلیدی که در مادربردهای X870E و X870 ارتقا یافته‌اند شامل استانداردسازی USB ۴.۰ و PCIe Gen5 هم برای کارت گرافیک و هم برای درایوهای NVMe در تمام مدل‌هاست. پشتیبانی از پروفایل‌های حافظه EXPO با فرکانس‌های بالاتر در این بسترها بهبود یافته است. AMD همچنین الگوریتم‌های جدید PBO و Curve Optimizer را برای پردازنده‌های رایزن ۹۰۰۰ معرفی کرده که این مادربردها به طور کامل از آن‌ها بهره می‌برند.

چیپست‌های میان‌رده و سطح پایه: B850 و B840

علاوه بر موارد فوق، چیپست‌های B850 و B840 بخش مین‌استریم بازار را هدف قرار می‌دهند. سری X870E از دو دای Promontory ۲۱ با پشتیبانی از USB4 و دو مسیر Gen5 بهره می‌برد. مدل X870 تنها یک دای دارد، اما همچنان امکانات ورودی/خروجی را با خطوط ارتباطی کمتر حفظ می‌کند. این مادربردها به طور بومی از حافظه DDR5-۵۶۰۰ پشتیبانی می‌کنند و در برخی مدل‌های پرچم‌دار نرخ انتقال فراتر از ۸۰۰۰ مگاترانسفر بر ثانیه را می‌رساند.

مادربردهای B850 مجهز به همان دای Promontory ۲۱ خواهند بود، اما فاقد پشتیبانی بومی USB4 هستند. آن‌ها از PCIe Gen5 برای کارت گرافیک پشتیبانی می‌کنند، اما فعال‌سازی Gen5 برای اسلات M.۲ در این تراز اختیاری است. تراز B840 به عنوان گزینه سطح پایه با دای قدیمی‌تر Promontory ۱۹ عرضه می‌شود که به معنای پشتیبانی تا Gen4، عدم امکان اورکلاک پردازنده و پشتیبانی تنها از اورکلاک حافظه است.

سوکت AM5: از PGA به LGA

سوکت AM5 که جانشین AM4 شده، از طراحی PGA به LGA دگرگون شده است. سوکت جدید LGA ۱۷۱۸ تعداد بیشتری اتصال پین را به پردازنده ارائه می‌دهد. این امر امکان برقراری کانال‌های ارتباطی بیشتر با برد را فراهم آورده و پشتیبانی از ویژگی‌های پیشرفته پلتفرم جدید را ممکن می‌سازد. AMD برنامهٔ پشتیبانی از سوکت AM5 را تا سال ۲۰۲۷ و فراتر از آن متعهد شده است.

سازگاری حرارتی و ابعاد پردازنده‌ها

پردازنده‌های دسکتاپ سری ۷۰۰۰، ۸۰۰۰ و ۹۰۰۰ دارای بدنه مربعی کامل (۴۵ در ۴۵ میلی‌متر) با یک پخش‌کننده حرارتی یکپارچه و ضخیم هستند. ابعاد این تراشه‌ها مشابه نسل‌های قبلی رایزن است و لبه‌های آن‌ها صاف و یکدست طراحی شده‌اند. این طراحی تضمین می‌کند که خنک‌کننده‌های موجود در بازار به طور کامل با جدیدترین پردازنده‌های رایزن سازگار خواهند بود و نیازی به تعویض حلول خنک‌کننده برای ارتقای سیستم نیست.

همکاری استراتژیک برای توسعه تراشه‌های هوش مصنوعی سفارشی

شراکت استراتژیک و برای توسعه تراشه‌های هوش مصنوعی سفارشی

شرکت OpenAI با همکاری Broadcom در حال توسعه تراشه‌های هوش مصنوعی اختصاصی است تا کنترل سخت‌افزاری زیرساخت مدل‌های زبانی خود را در دست بگیرد. این اتحاد فراتر از ارتقای توان پردازش، گامی است به سوی استقلال از تک‌فروشنده‌های سخت‌افزاری و بهینه‌سازی مصرف انرژی در مقیاس وسیع.

هدف اصلی: کاهش وابستگی به انویدیا و تسلط بر زنجیره تأمین

به گزارش رسانه‌های فناوری، انگیزه محوری این همکاری، کاستن از وابستگی به پردازنده‌های گرافیکی NVIDIA و ایجاد بستر سخت‌افزاری انعطاف‌پذیر برای نسل‌های آتی مدل‌های بزرگ زبانی (LLM) است. OpenAI با این حرکت از حوزه محض نرم‌افزار به طراحی سخت‌افزار اختصاصی می‌روید تا بتواند معماری تراشه را مستقیماً با نیازهای آموزش و استنتاج (Inference) مدل‌های خود هم‌سازگار کند.

نقش Broadcom: معماری تراشه و زیرساخت شبکه‌ای پیشرفته

Broadcom در این اتحاد نقش کلیدی در طراحی تراشه‌های مخصوص بارهای کاری هوش مصنوعی و ارائه راهکارهای اتصال نوری با باندوidth بالا و تأخیر پایین برای مراکز داده ایفا می‌کند. این زیرساخت‌های شبکه‌ای امکان مقیاس‌پذیری افقی کلاسترهای آموزشی را با کارایی انرژی بهتر فراهم می‌آورند.

برنامه زمانی و مقیاس استقرار

نخستین سیستم‌های مبتنی بر این تراشه‌های سفارشی برای سال ۲۰۲۶ برنامه‌ریزی شده‌اند و استقرار گسترده‌تر تا افق ۲۰۲۹ پیش‌بینی می‌شود. این زمان‌بندی هم‌چنان با استراتژی سام ألتمن، مدیرعامل OpenAI، برای تضمین ظرفیت تولید تراشه از طریق TSMC و تنوع زنجیره تأمین هم‌سو است.

تفاوت رویکرد OpenAI با رقبا

برخلاف گوگل (TPU)، آمازون (Trainium/Inferentia) و متا (MTIA) که تراشه‌های خود را به‌صورت کاملاً داخلی طراحی کرده‌اند، OpenAI مدل همکاری با شریک باتجربه را برگزیده تا زمان توسعه و هزینه‌های NRE (مهندسی غیربازگشتی) را کاهش دهد، در حالی که کنترل معماری و ویژگی‌های تراشه را در دست خود نگه می‌دارد.

مزایای پیش‌بینی‌شده: کارایی انرژی، هزینه و مقیاس‌پذیری

تراشه‌های بهینه‌شده برای بارهای کاری خاص هوش مصنوعی انتظار می‌رود مصرف انرژی را به‌شکل قابل‌توجهی کاهش دهند، هزینه‌های آموزش مدل‌های تریلیون‌پارامتری را پایین بیاورند و امکان استقرار شتاب‌دهنده‌های سفارشی در مقیاس ۱۰ گیگاوات را برای OpenAI محقق سازند.

چالش‌های پیش‌رو و ضرورت یکپارچه‌سازی سخت‌افزار/نرم‌افزار

توسعه تراشه اختصاصی هوش مصنوعی نیازمند سال‌ها تحقیق، سرمایه‌گذاری چندمیلیاردی و هماهنگی تنگاتنگ تیم‌های سخت‌افزار و نرم‌افزار برای یکپارچه‌سازی بی‌نقص با پشته نرم‌افزاری موجود (مانند PyTorch، Triton و کتابخانه‌های بهینه‌سازی OpenAI) است. موفقیت این پروژه بستگی به مدیریت ریسک‌های طراحی، تأیید سیلیکون (Silicon Validation) و پایداری زنجیره تأمین فابریکیشن دارد.

افق استراتژیک: استقلال طولانی‌مدت و قابلیت‌های نوین

با وضع بنیاد سخت‌افزاری مستقل، OpenAI می‌کوشد تا دانش حاصل از مقیاس‌سازی مدل‌ها را مستقیماً در معماری سیلیکون تعبیه کند، لایه‌های جدیدی از هوشمندی و کارایی را باز نماید و موقعیت رقابتی خود را در عصر هوش مصنوعی عمومی (AGI) تثبیت سازد.

همکاری سونی و AMD برای گرافیک پیشرفته پلی‌استیشن

همکاری پروژه آمتیست سونی و AMD؛ انقلاب گرافیکی نسل آینده پلی‌استیشن

مارک سرنی، معمار ارشد و نسل‌ساز کنسول‌های پلی‌استیشن، اخیراً جزئیات استراتژیک و پیشروانه‌ای درباره پروژه آمتیست (Project Amethyst) فاش کرد. این طرح، حاصل هم‌افزایی راهبردی میان سونی اینتراکتیو اینترتینمنت و ای‌ام‌دی است که به هدف بازتعریف آینده پردازش گرافیکی تدوین شده است.

سه ستون اصلی فناوری پروژه آمتیست

در یک به‌روزرسانی رسمی ویدئویی، دو غول فناوری از سه قابلیت کلیدی پرده برداشتند که قرار است بنیاد پردازنده‌های گرافیکی نسل آینده ای‌ام‌دی و کنسول‌های پیش رو — از جمله پلی‌استیشن ۶ — را شکل دهند:

  • آرایه‌های عصبی (Neural Arrays): تسریع محاسبات یادگیری ماشین در سخت‌افزار گرافیکی.
  • هسته‌های رادیانس (Radiance Cores): واحدهای اختصاصی برای پیشبرد رهگیری پرتو (Ray Tracing) در زمان واقعی.
  • فشرده‌سازی جهانی (Universal Compression): روشی واحد برای کاهش حجم داده‌های گرافیکی در کل خط لوله رندرینگ.

تحول استراتژی سخت‌افزاری سونی

سرنی تأکید کرد که رویکرد سونی نسبت به دوران پلی‌استیشن ۵ پرو، دگرگونی بنیادینی را تجربه کرده است. در گذشته تمرکز بر توسعه فناوری‌های کاملاً انحصاری برای اکوسیستم پلی‌استیشن متمرکز بود، در حالی که اکنون مهندسی مشترک با ای‌ام‌دی بر روی نقشه‌راه عمومی سخت‌افزاری این شرکت قرار گرفته است.

او معتقد است این چرخش، انگیزه توسعه‌دهندگان را برای بکارگیری قابلیت‌های نوین تقویت می‌کند، زیرا اطمینان حاصل می‌کنند که نوآوری‌هایشان در طیف وسیعی از پلتفرم‌ها — از کامپیوترهای شخصی و لپ‌تاپ‌ها تا کنسول‌ها — قابل اجرا خواهند بود. سرنی از «تأثیرات خیره‌کننده» این فناوری‌ها در آینده نزدیک خبر داد.

چالش‌های سنجش مزایا و گره‌های عملیاتی

با وجود پتانسیل بالا، معمار ارشد پلی‌استیشن تصریح کرد که کمی‌سازی دقیق مزایای این فناوری‌ها در مرحله فعلی دشوار یا ناممکن است. در مورد فشرده‌سازی جهانی، او به ضرورت ارزیابی هم‌افزایی با الگوریتم‌های سوپررزولوشن مبتنی بر یادگیری ماشین — نظیر FSR و PSSR — و کیفیت فشرده‌سازی نقشه‌های ویژگی اشاره کرد.

در خصوص هسته‌های رادیانس نیز، اگرچه رویکرد پردازشیِ بسیار قدرتمندی ارائه می‌دهند، اما حداکثر بهره‌وری از آن‌ها بستگی به دستیابی توسعه‌دهندگان بازی به نمونه‌های اولیه سخت‌افزاری و تطبیق موتورهای بازی دارد. سرنی خاطرنشان کرد که تمامی این ویژگی‌ها اکنون در فاز شبیه‌سازی (Emulation) قرار دارند و مسیر عملیاتی شدن آن‌ها نیازمند زمان است.

فشرده‌سازی جهانی: کلید گشوده شدن تنگناهای حافظه

سرنی اهمیت حیاتی فشرده‌سازی جهانی را تأکید کرد، چراکه افزایش پهنای باند حافظه در هر نسل سخت‌افزاری به طور فزاینده‌ای چالش‌برانگیزتر شده است. او پذیرفت که سونی و ای‌ام‌دی در نسل سخت‌افزاری آتی، اولویت اصلی را بر تقویت قابلیت‌های رهگیری پرتو و یادگیری ماشین متمرکز کرده‌اند.

در این رویکرد، رندرسازی سنتی (Rasterization) تنها در موارد ضروری بهبود می‌یابد و دیگر محور اصلی توسعه نیست.

هم‌سویی با شایعات پلی‌استیشن ۶

این التحول با گزارش‌های غیررسمی پیرامون پلی‌استیشن ۶ کاملاً هم‌جهت است. بر اساس شایعات، کنسول نسل بعد که احتمالا در سال ۲۰۲۷ معرفی می‌شود، عملکرد رندرسازی سنتی را تا ۲.۵ تا ۳ برابر تقویت خواهد کرد، در حالی که کارایی رهگیری پرتو با جهشی عظیم، ۶ تا ۱۲ برابر سریع‌تر عمل خواهد نمود.

افزایش جوایز امنیتی اپل برای ترغیب پژوهشگران در کشف آسیب‌پذیری‌های پیشرفته

افزایش جوایز امنیتی اپل؛ ترغیب پژوهشگران برای کشف آسیب‌پذیری‌های پیشرفته

اپل ساختار برنامه پاداش امنیتی خود را به‌شکل اساسی بازنگری کرده تا محققان را به شناسایی و گزارش نقاط ضعف ترغیب نماید. این گام استراتژیک با افزایش چشمگیر مبالغ جایزه همراه است. برنامه‌ای که از سال ۱۴۰۰ آغاز شده و تاکنون بیش از ۳۵ میلیون دلار به نزدیک ۸۰۰ محقق امنیتی پرداخت نموده، اکنون با بازدهی‌های بسیار جذاب‌تر روبروست.

جزئیات افزایش جوایز در برنامه امنیت اپل

بر اساس اطلاعیه رسمی منتشرشده در وبلاگ اپل، این شرکت مبلغ جایزه اصلی خود را دوچندان نموده و سقف آن را به ۲ میلیون دلار رسانده است. این مبلغ بابت کشف زنجیره‌های بهره‌برداری پیچیده — مشابه حملات جاسوس‌افزارهای پیشرفته — پرداخت می‌گردد. با احتساب پاداش‌های تکمیلی برای دورزدن حالت Lockdown و آسیب‌پذیری‌های موجود در نسخه‌های بتا، حداکثر پاداش قابل دسترس تا سقف ۵ میلیون دلار افزایش یافته است.

جایزه‌های تخصصی برای حملات سطح‌بالا

  • دورزدن Gatekeeper در macOS: اپل برای یافتی روش کامل دورزدن این مکانیزم امنیتی، جایزه ۱۰۰ هزار دلاری در نظر گرفته است.Successfully عبور از گیت‌کیپر به کدهای مخرب اجازه اجرای ناشناس در سیستم را می‌دهد.
  • دسترسی غیرمجاز به iCloud: کشف مسیرهای نفوذ گسترده به خدمات ابری اپل، پاداش یک میلیونی دارد.
  • فرار از Sandbox وب‌کیت (WebKit): آسیب‌پذیری‌های یک‌کلیکی امکان‌پذیر‌ساز خارج‌شدن از محیط ایزوله، تا ۳۰۰ هزار دلار جایزه دارند.
  • حمله‌های بی‌سیم: کشف نقص‌های امنیتی از طریق هر نوع واسط رادیویی، می‌تواند تا یک میلیون دلار درآمدزای محققان باشد.

تأثیر برنامه بر تقویت اکوسیستم اپل

این برنامه در طول سال‌ها نقش بسزایی در ارتقای امنیت محصولات اپل ایفا کرده است. نتایج ملموس آن شامل موارد زیر می‌شود:

    معرفی حالت Lockdown Mode برای محافظت از اهداف پرریسک.
  • ترقی معماری امنیتی مرورگر سافاری.
  • پیاده‌سازی مکانیزم‌های حفاظت یکپارچگی حافظه در تراشه‌های نسل جدید.

تحلیل سطح تهدیدات فعلی

اپل تأکید می‌کند که نتیجه مستقیم این سرمایه‌گذاری‌ها، ارتقای سطح امنیت به حدی است که حملات موثر در سطح سیستم‌عامل iOS تنها از طریق جاسوس‌افزارهای بسیار پیچیده و پرهزینه امکان‌پذیر مانده است. توسعه و استقرار چنین بدافزارهایی هزینه‌های چندمیلیونی دارد و دامنه اهداف آن‌ها به تعداد بسیار محدودی از افراد خاص محدود می‌شود. این واقعیت گواهی بر بلوغ و استحکام بالای معماری امنیتی اکوسیستم اپل است.

معماری گرافیک Xe3، بهبود ۵۰٪ عملکرد نسبت به نسل قبل

معماری گرافیک جدید Xe۳؛ نوید‌بخش ۵۰٪ افزایش عملکرد نسبت به نسل قبلی

اینتل معماری گرافیکی تازه خود را تحت نام Xe3 معرفی کرد. این معماری در پردازندهای گرافیکی یکپارچه سری Core Ultra 300 با نام کد Panther Lake به کار خواهد گرفته شد و بر پایادهiyot‌های نسل قبلی یعنی Xe2 ساخته شده است. نسل دوم این معماری که در پردازنده‌های Core Ultra 200 با نام کد Lunar Lake و کارت‌های گرافیک مجزای سری Arc B-Series با نام کد Battlemage استفاده می‌شد، اکنون به Xe3 વધížت می‌یابد.

به گزارش بخش سخت‌افزار رسانه‌ی فناوری تکنا، اینتل در زمینه سخت‌افزار و نرم‌افزار پیشruzهای قابل‌توجهی داشته و حمایت از درایورها برای بازی‌ها، تولید محتوا و بارهای کاری هوش مصنوعی را تقویت کرده است. معماری Xe3 promises افزایش عملکرد بیش از ۵۰ درصد نسبت به Xe2 را دارد. این بهبود از طریق افزایش تعداد shaderها، هسته‌های Xe و واحدهای رهگیری پرتو به‌دست آمده است. همچنین، Xe3 شامل یک واحد رهگیری پرتو پیشرفته با مدیریت پویای پرتو برای رهگیری پرتو ناهمزمان است.

یک مدیر URB تازه برای به‌روزرسانی‌های جزئی و بهبود فیلتر ناهمسانگرد و نرخ تست استنسیل نیز از ویژگی‌های این معماری است. در بخش رسانه، Xe3 از کدگذاری و décodage فرمت‌های AV1، VVC و همچنین eDP 1.5 پشتیبانی می‌کند. اینتل همچنین به برنامه‌های آینده خود اشاره کرده و معماری به‌روزشده Xe3P برای خانواده آینده Arc در دست ساخت است که احتمالاً به سری Arc C مربوط خواهد شد.

معیارهای اولیه عملکرد Xe3 بهبودهای قابل‌توجهی را در میکروبنچمارک‌های گوناگون نشان می‌دهد و برخی از برنامه‌ها تا ۷ برابر افزایش عملکرد را تجربه کرده‌اند. در کاربرد واقعی، انتظار می‌رود Xe3 بیش از ۵۰ درصد عملکرد بالاتر نسبت به Lunar Lake و بیش از ۴۰ درصد عملکرد بالاتر در هر وات نسبت به Arrow Lake-H ارائه دهد.

اولین تراشه‌های ۱۸A اینتل در ایالات متحده

معرفی اولین تراشه‌های ۱۸A اینتل در خاک آمریکا: پانتر لیک و کلووتر فارست

در رویداد Tech Tour ۲۰۲۵، الفرصه‌ای برای بررسی نزدیک نخستین تراشه‌های مبتنی بر فرآیند ۱۸A اینتل، یعنی Panther Lake و Clearwater Forest، فراهم شد. در بازدید از فاب ۵۲ (Fab ۵۲) که مرکز حیاتی ساخت و استقرار نسل جدید تراشه‌های اینتل محسوب می‌شود، ویفرها و تراشه‌های برپایه این فناوری پیشرفته به نمایش درآمدند. اولین محصولاتی که از این فرآیند بهره‌مند می‌شوند، Panther Lake برای دستگاه‌های کلاینت و Clearwater Forest برای سرورها خواهند بود که هر دو در سال ۲۰۲۶ ارائه می‌گردند.

جزئیات معماری Panther Lake و پیکربندی‌های مختلف

به گزارش بخش نیمه‌هادی رسانه تکنا، در این رویداد دو پیکربندی متمایز از Panther Lake به همراه یک ویفر کامل Compute Tile آن به نمایش درآمد. پیکربندی 12Xe دارای Compute Tile با فناوری ۱۸A و یک تایل گرافیکی مبتنی بر فرآیند N3E شرکت TSMC است. در سوی دیگر، نسخه 4Xe از همان Compute Tile بهره می‌برد، اما تایل گرافیکی آن برپایه فناوری Intel ۳ ساخته شده است. هر دو نسخه از بسته‌بندی پیشرفته Foveros 2.5D اینتل استفاده می‌کنند که نشان‌دهنده پیچیدگی و پیشرفت چشمگیر در طراحی این پردازنده‌هاست.

پلتفرم اعتبارسنجی و کیت‌های توسعه

مادربرد پلتفرم اعتبارسنجی مرجع (RVP) برای Panther Lake نیز معرفی شد. این برد که برای بررسی و اعتبارسنجی پردازنده‌ها پیش از عرضه رسمی مورد استفاده قرار می‌گیرد، از سوکت BGA 2540 برای پشتیبانی از پردازنده‌های سری H و U بهره می‌برد. نکته قابل توجه در این مادربرد، بهره‌گیری از حافظه‌های LPCAMM2 به جای ماژول‌های سنتی SO-DIMM است که حرکت اینتل به سوی استانداردهای جدید حافظه را آشکار می‌سازد.

علاوه بر این، یک DevKit فشرده برای Panther Lake به نمایش گذاشته شد که توسعه‌دهندگان را قادر می‌سازد برنامه‌های خود را برای این پلتفرم نوین بهینه‌سازی کنند. همچنین ماژول اختصاصی برای پلتفرم‌های رباتیک و Edge معرفی گردید که پردازنده Panther Lake را به همراه حافظه‌های DRAM تعبیه‌شده روی یک برد مدار چاپی کوچک جای داده است؛ طراحی فشرده‌ای که پتانسیل بالای این تراشه برای کاربردهای متنوع را اثبات می‌کند.

Clearwater Forest: نسل جدید زئون برای سرورها

در بخش سرورها، تراشه نسل جدید Clearwater Forest (معروف به Xeon ۶+) با دوازده Compute Tile مبتنی بر فناوری ۱۸A رونمایی شد. این پردازنده از راه‌حل‌های بسته‌بندی پیشرفته Foveros 3D و EMIB برای ترکیب تایل‌های متنوع بهره می‌برد. ویفر Compute Tile این تراشه نیز که هر کدام شامل ۲۴ هسته Darkmont E-Core هستند، به نمایش درآمد. این تراشه‌ها با سوکت LGA 7529 سازگار هستند که امکان ارتقای آسان پلتفرم‌های موجود را فراهم می‌آورد.

نمایش‌های زنده: کارایی انرژی و عملکرد گرافیکی

در بخش دموهای زنده، لپ‌تاپ‌های متعددی مجهز به Panther Lake در حال اجرای سناریوهای مختلف بودند. یکی از این دموها عملکرد جزیره کم‌مصرف (Low Power Island) را با چهار هسته Darkmont E-Core بررسی می‌کرد که در مقایسه با Arrow Lake و Lunar Lake، مصرف انرژی مشابه یا کمتری در بارهای کاری سبک را نشان داد. این سیستم در مقایسه با Arrow Lake حدود ۳۵ درصد مصرف انرژی کمتری داشت که نشان‌دهنده بهبود چشمگیر بهره‌وری است.

در دموی گیمینگ، بازی Painkiller روی پردازنده Panther Lake 12Xe با توان ۴۵ وات و تنظیمات Epic در رزولوشن ۱۰۸۰p اجرا شد. در حالت معمول، بازی با نرخ ۵۰ تا ۶۰ فریم بر ثانیه اجرا می‌شد، اما با فعال‌سازی XeSS 3 و حالت MFG 4x، نرخ فریم به بیش از ۲۰۰ رسید که تجربه گیم‌پلی بسیار روانی را به ارمغان آورد. اینتل تأکید کرد که این نسخه اولیه مدل XeSS ۳ MFG است و نسخه نهایی کیفیت و عملکرد بهتری خواهد داشت.

دموی دیگر مربوط به حالت Smart Power HDR بود که به پردازنده‌های Panther Lake اجازه می‌دهد مصرف انرژی را به میزان قابل‌توجهی کاهش دهند و قابلیت‌های HDR را بدون نیاز به سطوح استاندارد مصرف انرژی ارائه کنند. این حالت نزدیک به ۲۰ درصد در مصرف انرژی پنل صرفه‌جویی می‌کند. برای Clearwater Forest نیز دموهایی نظیر کنترل ۵G نمایش داده شد که در آن این تراشه بیش از دو برابر عملکرد بهتری نسبت به پردازنده‌های Sierra Forest در بارهای کاری 5G Core ارائه می‌داد.

کارت گرافیک Radeon RX 9070 XT با اختلافی ۳۱ درصدی RTX 5070 Ti را در بازی کالاف در هم کوبید

RX ۹۰۷۰ XT با ۳۱ درصد برتری نسبت به RTX ۵۰۷۰ در کالاف داتی أوپس ۷

آزمایش‌های اولیه روی نسخه بتای بازی Call of Duty: Black Ops ۷ نتایج شگفت‌انگیزی را نشان داده و مشخص می‌شود که این بازی به‌طور قابل‌توجهی به‌عهد cartهای گرافیکی مبتنی بر معماری RDNA ۴ شرکت AMD عمل می‌کند.

به نقل از بخش سخت‌افزار و گیم رسانه اخبار فناوری و تکنولوژی تکنا، وب‌سایت Computer Base در ارزیابی‌های خود عملکرد کارت‌های گرافیک تازه AMD و NVIDIA و Intel را مورد مقایسه قرار داد و تفاوت عملکردی چشمگیری بین آن‌ها مشاهده کرد. در حالی که در اکثر بازی‌ها رقابت نزدیک بین کارت‌های گرافیک هم-surface معمول است، یک تفاوت دو رقمی در عملکرد به‌عنوان یک اتفاق نادر محسوب می‌شود.

این تست‌ها با فعال‌سازی فناوری‌های ارتقاء تصویر در حالت کیفیت انجام شده‌اند. بازی تازه از DLSS ۴ پشتیبانی می‌کند اما در حال حاضر پشتیبانی بومی از FSR ۴ ندارد. با این حال، با استفاده از درایورهای تازه Adrenalin می‌توان از FSR ۳.۱ بهره برد و این قابلیت را در پردازندهای RDNA ۴ به معادل FSR ۴ ارتقا داد و Computer Base نیز از این روش برای تست کارت Radeon RX ۹۰۷۰ XT استفاده کرد.

نتایج نشان می‌دهد کارت گرافیک Radeon RX ۹۰۷۰ XT که بهترین پردازشگر AMD در سری RX ۹۰۰۰ محسوب می‌شود، توانست با muita rebalancing رقیب مستقیم خود یعنی GeForce RTX ۵۰۷۰ Ti را شکست دهد. در حالی که به‌طور معمول RTX ۵۰۷۰ Ti نزدیک به ۶ تا ۷ درصد سریع‌تر از RX ۹۰۷۰ XT عمل می‌کند، در این بازی کارت گرافیک AMD با ارائه عملکردی ۳۱ درصد بهتر در رزولوشن 1440p پیش‌تزامی یک rekord قابل‌توجه ثبت کرد.

این کارکرد نه تنها به‌سبب شکستن رقیب مستقیم خود قابل‌توجه است، بلکه برای rapprochement کردن با کارکرد کارت بسیار پرقدرت GeForce RTX ۵۰۹۰ نیز noteworthy است. این نتایج به‌À pont Cüt است که به‌نظر می‌رسد RX ۹۰۷۰ XT حتی از کارت گرافیک RTX ۵۰۸۰ نیز در این رزولوشن سریع‌تر باشد.

این برتری در رزولوشن‌های بالاتر همانند 3440x1440p و 4K نیز حفظ می‌شود و اگرچه فاصله کارکرد با RTX ۵۰۹۰ زیادتر می‌شود، اما RX ۹۰۷۰ XT همچنان به آسانی رقیب مستقیم خود را پشت سر می‌گذارد. علاوه بر این کارت گرافیک AMD در پایداری نرخ فریم و ارائه حداقل فریم ریت (۱% lows) نیز کارکرد بهتری داشته و توانایی روان‌تری را برای گیمرز فراهم می‌آورد.

نکته دل‌نشین این است که به‌نظر می‌رسد این بهینه‌سازی صرفاً به معماری تازه RDNA ۴ اختصاص دارد چون در نسل‌های قبلی همانند RX ۷۸۰۰ XT عملکرد برابر با رقیب مستقیم خود یعنی RTX ۴۰۷۰ را داشتیم. برای دیدن تصویر کامل‌تر از کارکرد معماری RDNA ۴ باید تا زمان ارaumeش رسمی بازی در ۱۴ نوامبر و انتشار بنچمارک‌های زیادتر از جمله برای کارت RX ۹۰۶۰ XT صبر کنیم.

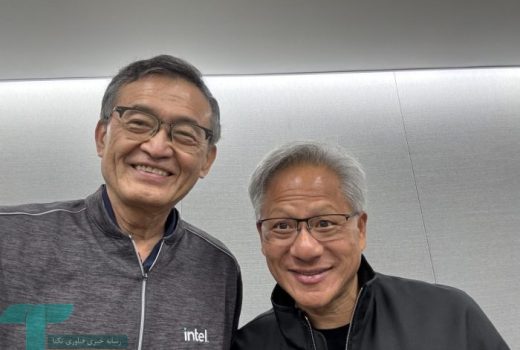
رحلة انویدیا از رقابت با اینتل تا همکاری استراتژیک در هوش مصنوعی

تحول انویدیا: از رقیب تحت فشار اینتل تا متحد استراتژیک در عصر هوش مصنوعی

جنسن هوانگ، مدیرعامل انویدیا، در مصاحبه‌ای دلنشین به مسیر پرتلاطم این شرکت و رقابت دیرینه‌اش با غول تراشه‌سازی اینتل پرداخت. او تأکید کرد که اینتل در طول سه دهه تلاش بی‌وقفه‌ای برای حذف انویدیا از صحنه رقابت داشته، اما سرنوشت و نوآوری مسیر متفاوتی را برای هر دو رقم زد.

از چالش بقا تا رقابت با فرمانروای بازار

در اواسط دهه ۲۰۰۰ میلادی، اینتل به عنوان حاکم بلامنازع صنعت محاسبات، سلطه کامل بر بازارهای مصرفی و حرفه‌ای را در اختیار داشت. در مقابل، انویدیا بازیگری کوچک‌تر بود که با پیشرفت‌های مداوم و نوآوری‌های ساختارشکن، پایه‌های این حکومت را لرزاند. هوانگ در گفتگو با جیم کرامر، خاطرات آن دوران را زنده کرد و به سوالی درباره همکاری جاری و احساسات ناشی از مقابله با مدیران ارشد اینتل همچون اندی گروو پاسخ داد.

۳۳ سال تلاش برای حذف رقیب

مدیرعامل انویدیا فاش کرد که اینتل در طول ۳۳ سال عمر این شرکت، کوشیده تا آن را از میدان رقیبی خارج سازد. اگرچه لحن هوانگ طنزآمیز بود، اما واقعیت تنش‌های عمیق را بازتاب می‌داد. گزارش‌ها و اسناد حقوقی متعدد حکایت از آن دارد که اینتل با بهره‌گیری از قراردادها و مجوزهای مالکیت معنوی، تلاش به سرکوب رقبا داشته است. نمونه بارز، مناقشه حقوقی بر سر قرارداد ساخت چیپست برای پردازنده‌های اینتل بود که در آن انویدیا پیروز میدان شد؛ این تنها گوشه‌ای از درگیری‌های دو غول تکنولوژی است.

فصل جدید: همکاری برد-برد با دیدگاه استراتژیک

با وجود تاریخچه پرتنش، هوانگ نسبت به توافق تازه با اینتل ابراز خوش‌بینی کرد و نقش لیپ-بو تان، مدیرعامل جدید اینتل، در تحقق این اتحاد را ستود. او این معامله را برد-برد توصیف کرد: انویدیا با تولید تراشه برای اینتل، به بازاری چند میلیارد دلاری در بخش مصرفی دسترسی می‌یابد و اینتل نیز با طراحی پردازنده‌های x86 برای راهکارهای مقیاس‌پذیر انویدیا، جایگاه خود در قلب دیتاسنترهای آینده را تقویت می‌کند.

قدرت در هم‌افزایی، نه در حذف حریف

تاریخ فناوری بارها ثابت کرده که فروتنی و انعطاف‌پذیری، کلید بقاست. انویدیا که روزی برای بقا می‌جنگید، اکنون به موقعیتی رسیده که همکاری با آن، ارزش سهام شرکای تجاری را به شدت بالا می‌برد. این اتحاد نمادین است: قدرت در حذف حریف نیست، بلکه در شناختن نقاط قوت متقابل و ساخت اکوسیستم‌های مشترک برای پیشبرد هوش مصنوعی و محاسبه‌گرهای نسل بعد نهفته است.

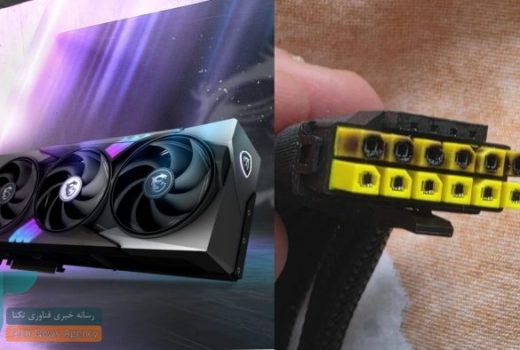
کارت گرافیک MSI RTX 5090 با کانکتور برق ذوب شده

کارت گرافیک MSI RTX ۵۰۹۰ برای دومین بار قربانی ذوب کانکتور برق شد

یک کاربر در ردیت گزارش داد که کارت گرافیک MSI GeForce RTX 5090 Gaming Trio او در عرض کمتر از دو ماه برای دومین بار با ذوب کانکتور ۱۶ پین برق روبرو شده است. کارت اول در جولای دچار این مشکل شد و پس از مراجعه به گارانتی (RMA)، واحد جایگزین در آگوست تحویل داده شده بود.

علت احتمالی: استفاده از آداپتور ۴x۸ پین به ۱۶ پین MSI

کاربر برای تغذیه کارت از منبع Corsair SF1000 (سازگار با ATX ۳.۱) استفاده می‌کرد، اما به جای کابل بومی ۱۲VHPWR/۱۲V-۲×۶، از آداپتور ۴x۸ پین به ۱۶ پین MSI با نوک زرد بهره گرفته بود. کارشناسان معتقدند این نوع آداپتورها به دلیل طراحی ضعیف و عدم توازن بار، سابقه طولانی در ایجاد مشکلات ذوب دارند.

تحلیل کارشناسان

اگرچه کاربر ادعا می‌کند اتصال به درستی و به طور کامل انجام شده، اما کارشناسان سخت‌افزار هشدار می‌دهند که اتصال فیزیکی کامل لزوماً توزیع جریان الکتریکی مناسب را در سراسر آداپتور تضمین نمی‌کند. ترکیب نقص طراحی آداپتور و عوامل ثانویه مرتبط با منبع تغذیه، احتمالاً باعث تکرار این حادثه شده است.

این رویداد نگرانی‌های گسترده‌تری را درباره پایداری کانکتورهای ۱۶ پین در کارت‌های نسل جدید RTX ۵۰۹۰ و قطعات پرمصرف دیگر برانگیخته است.

1 2 3 4 … 55